Titre original : SPAR: Experience-Driven Strategy Evolution in Multi-Session B2B Sales
Auteurs : Hangming Zhang, Yao Zhao (contribution égale), Haotian Kuang, C. L. Philip Chen, Tong Zhang et Tengyue Ma (auteur de correspondance).
Affiliations : South China University of Technology (Hangming Zhang, C. L. Philip Chen, Tong Zhang) et Alibaba Group (Yao Zhao, Haotian Kuang, Tengyue Ma). Hangming Zhang a mené ce travail pendant un stage chez Alibaba. Le financement cite le « CCF-1688 Yuanbao Cooperation Fund » et un programme de recherche de la province du Guangdong.
Publication : prépublication arXiv 2611.01695v1 (cs.AI), déposée le 1er novembre 2026.
Liens : page arXiv, PDF.
L’idée en bref
Dans la vente entre entreprises, on ne conclut presque jamais au premier contact. Il faut relancer, se souvenir de ce que le client a dit, et savoir quelles approches fonctionnent. Les agents de vente à base de modèles de langage, eux, traitent le plus souvent chaque appel comme un événement isolé. Ceux qui apprennent de l’expérience stockent des leçons en texte libre et traitent tous les résultats comme également instructifs, alors qu’un refus peut venir d’une mauvaise stratégie comme d’un facteur extérieur (le budget, la saison, l’humeur du moment).
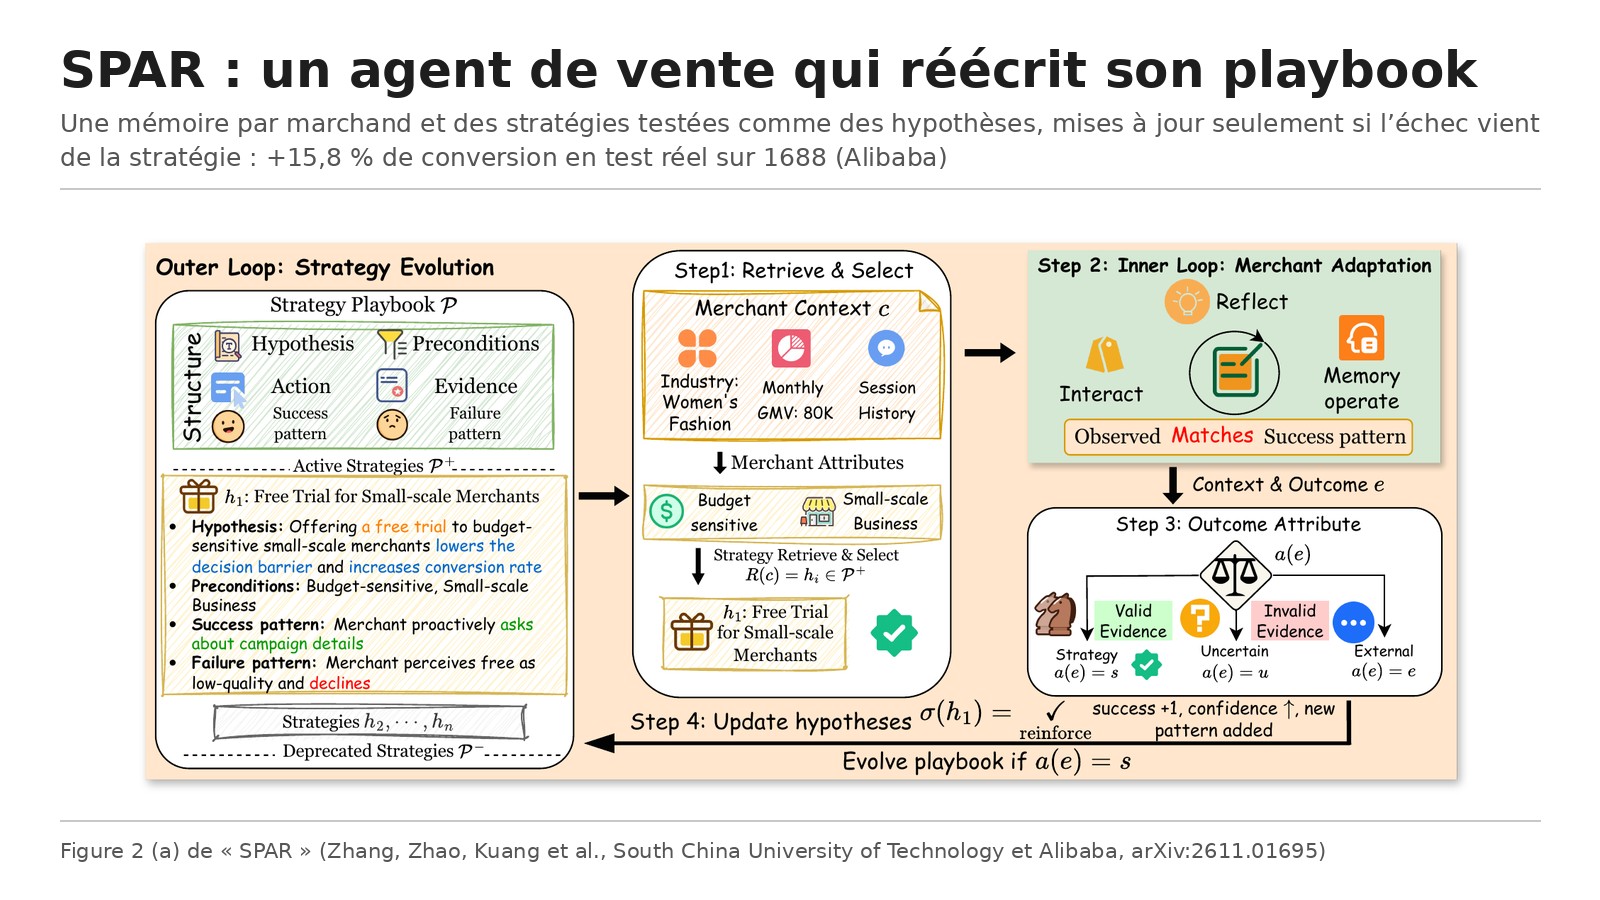
SPAR répond avec deux boucles. La boucle interne garde une mémoire propre à chaque marchand, avec une réflexion après chaque session, pour que la relance tienne compte de l’historique. La boucle externe gère un playbook partagé de stratégies, chacune écrite comme une hypothèse testable avec ses conditions d’emploi, ses actions et ses preuves. Après chaque conversation, un modèle attribue le résultat : dû à la stratégie, dû à un facteur extérieur, ou incertain. Seuls les résultats attribués à la stratégie la font évoluer, sans aucune mise à jour des paramètres du modèle.
Ce que montre le papier
Le dispositif
Le playbook est semé avec six stratégies provisoires et plafonné à 50 entrées. Chaque stratégie porte un indice de confiance qui part de 0,5 et converge vers son taux de réussite réel au fil des preuves (une loi Bêta-Bernoulli). Elle devient active ou est retirée selon des seuils de preuves. Le modèle choisit parmi sept actions d’évolution, de la simple confirmation à la fusion ou au retrait, en préférant toujours la plus petite révision suffisante. Tous les agents utilisent GPT-4o.
Le jeu d’évaluation vient de 1 642 conversations réelles entre une équipe commerciale expérimentée et des marchands de 1688, une grande place de marché en ligne entre entreprises. Le schéma des hypothèses a été conçu sur 51 603 notes de session d’une équipe performante et vérifié sur 3 637 cas, sans recoupement avec ces conversations. En simulation, GPT-4o joue le marchand. Les auteurs vérifient ce simulateur en rejouant 300 conversations réelles : 98,7 % d’accord sur l’issue, 91 % des comportements clés retrouvés, 87 % de précision quand il faut distinguer une bonne d’une mauvaise stratégie, 89 % d’approbation par l’équipe commerciale.
En simulation
Comparé à un agent sans mémoire (Direct Prompting) et aux méthodes Reflexion et ExpeL, SPAR obtient les meilleurs scores sur la reconnaissance de l’objection du marchand (0,832 contre 0,759 pour la meilleure méthode concurrente, soit plus 9,6 %) et sur les preuves apportées à l’appui des réponses (0,709 contre 0,672, soit plus 5,5 %), jugés par GPT-4o. Il répète le moins (0,002 de reprises d’un échange précédent) et rappelle le plus souvent des faits de la session précédente (0,071). Trois experts du métier, en aveugle, lui donnent 4,62 sur 5 pour la qualité globale de vente, contre 3,97 pour Reflexion, 3,64 pour ExpeL et 2,83 pour l’agent sans mémoire.
En test réel sur 1688
Le test A/B réel compare les méthodes sur plus de 30 000 marchands par groupe. La conversion est une transaction ciblée conclue dans les 7 jours suivant la dernière session de relance. Tous les chiffres suivants sont relatifs à l’agent sans mémoire.
- SPAR : conversion plus 15,8 %, nombre de sessions moins 9,2 %, taux de marchands à forte intention (indicateur M1) plus 35,8 %.
- Reflexion : plus 9,6 % de conversion. ExpeL : plus 1,1 %.
- Sans boucle interne : plus 10,1 %. Sans boucle externe : plus 12,6 % (et moins 11,2 % de sessions). Sans évolution du playbook : plus 9,6 %, avec une hausse de seulement 18,7 % du taux de forte intention.
Les gains de SPAR sont significatifs à p inférieur à 0,001. Le papier note que l’avantage sur la meilleure variante suivante est de 25,4 % en relatif (15,8 contre 12,6).
Comment le playbook évolue
Sur un échantillon de plus de 200 marchands du test, les auteurs suivent le playbook de façon qualitative. Deux des six stratégies de départ deviennent actives : celle qui consiste à rappeler la conversation précédente avec un marchand revenu (108 succès attribués à la stratégie) et celle qui propose un programme d’essai quand le marchand hésite (89). Deux autres sont retirées après des échecs répétés, et cinq nouvelles stratégies sont découvertes et validées. Neuf directions inexplorées sont repérées, par exemple proposer un accompagnement pratique à la mise en route ou des études de cas sectorielles.
Les limites
Les auteurs signalent que :
- SPAR a besoin de plusieurs interactions avant que le playbook évolue, donc les premiers marchands n’en profitent pas (démarrage à froid) ;
- l’évolution repose sur le raisonnement du modèle, qui introduit de l’aléatoire, et ils proposent un agent de vérification avant l’entrée d’une stratégie dans le playbook ;
- les marchands sont traités l’un après l’autre, alors qu’une équipe en suit plusieurs en parallèle.
Réserves de notre lecture :
- une seule plateforme et un seul domaine (l’outbound sur 1688), avec des auteurs dont une partie travaille chez Alibaba ; le papier n’annonce ni code ni données publiés ;
- les gains sont tous relatifs à l’agent sans mémoire : le taux de conversion de départ n’est pas donné, on ne sait donc pas ce que représentent 15,8 % en nombre de ventes ;
- la note de 4,62 sur 5 est une évaluation hors ligne par trois experts, pas un résultat du test réel ; le papier parle de dialogues avec « plus de 300 marchands réels » sans dire s’il s’agit des dialogues du simulateur, conditionné sur les profils réels ;
- l’analyse du playbook est qualitative et porte sur un échantillon de plus de 200 marchands ;
- la mention « plus de 200 000 marchands » du résumé et de la conclusion n’est pas détaillée : la section sur le test dit plus de 30 000 marchands par groupe, et sept variantes sont comparées, ce qui donne bien plus de 200 000 au total (c’est notre déduction, le papier ne le calcule pas) ;
- aucune expérience ne retire l’attribution causale seule : les ablations retirent la boucle interne, la boucle externe ou l’évolution, pas l’étiquetage de la cause d’un échec.
Lecture Neurone21
Pour une équipe commerciale qui veut automatiser des relances, le papier donne une règle simple à retenir : avant de réécrire un script de vente après un refus, demander si le refus vient du script ou d’autre chose. Un client qui dit « pas de budget ce trimestre » n’invalide pas l’argument commercial, et si l’agent le corrige quand même, il dégrade une stratégie qui marchait.
Un exemple concret : pour un distributeur qui relance des artisans par téléphone, garder une fiche par contact (ce qu’il a objecté, ce qu’on lui a promis) et une liste commune des approches, avec le nombre de réussites attribuées à chacune, suffit pour reprendre l’idée sans le système complet. Le papier montre que la mémoire par client et le playbook partagé contribuent chacun : sans l’un ou l’autre, le gain tombe à 10,1 ou 12,6 %.
Ce résultat prolonge nos fiches sur EMMA, des agents qui apprennent de leurs échecs, sur les agents auto-évolutifs qui oublient et sur la mémoire des agents rangée par familles de tâches chez Meta. À lire avec prudence : une seule plateforme, des gains relatifs sans taux de départ, et aucun code publié.
Le post d’Elvis Saravia est fidèle au papier. Précisions : le +15,8 % et le +35,8 % sont des variations relatives par rapport à l’agent sans mémoire, et la note de 4,62 est une évaluation hors ligne, pas un résultat du test réel.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.01695
- Le PDF : https://arxiv.org/pdf/2611.01695
- Le post d’Elvis Saravia : https://x.com/omarsar0/status/2117633659763339668