Titre original : GUARD: Stabilizing Recursive Self-Improvement with Regret Guidance
Auteurs : Minghe Zhang et Xuetao Kang (contribution égale), Yifei Ming, Yanfei Chen, Han Yu, Yufan Zhuang et Chen-Yu Lee.
Affiliation : Google Cloud.
Publication : prépublication déposée sur arXiv le 17 novembre 2026 (2611.23476v1, 38 pages avec annexes). Les auteurs prévoient de publier le code de référence du harnais, les relecteurs et les modèles de prompts « sous réserve d’approbation » ; aucun dépôt n’est disponible à ce jour.
Liens : page arXiv, PDF.
L’idée en bref
Un agent, c’est un modèle figé et un harnais : prompts, compétences, règles d’usage des outils, mémoire. L’auto-amélioration récursive consiste à laisser l’agent réécrire ce harnais à partir de son expérience, sans toucher aux poids du modèle. Le problème, connu, est que cela se retourne souvent contre lui quand personne ne note les résultats : une règle écrite pour corriger un échec récent casse des tâches qui marchaient, les nouvelles compétences écrasent les anciennes quand le travail change, et la mémoire se remplit de règles périmées ou contradictoires. Au bout de quelques tours, l’agent peut devenir moins bon qu’au départ.
L’idée de GUARD est de séparer deux signaux que les méthodes existantes mélangent : ce que la dernière modification a cassé, et ce que l’agent n’a jamais su faire. Les auteurs empruntent deux outils à l’apprentissage par renforcement, le « regret » de la conception non supervisée d’environnements et la comparaison au sein d’un groupe de candidats de la méthode GRPO, mais sans aucune mise à jour de poids : seul le texte du harnais change.
Ce que montre le papier
Une liste de contrôles établie avant d’agir
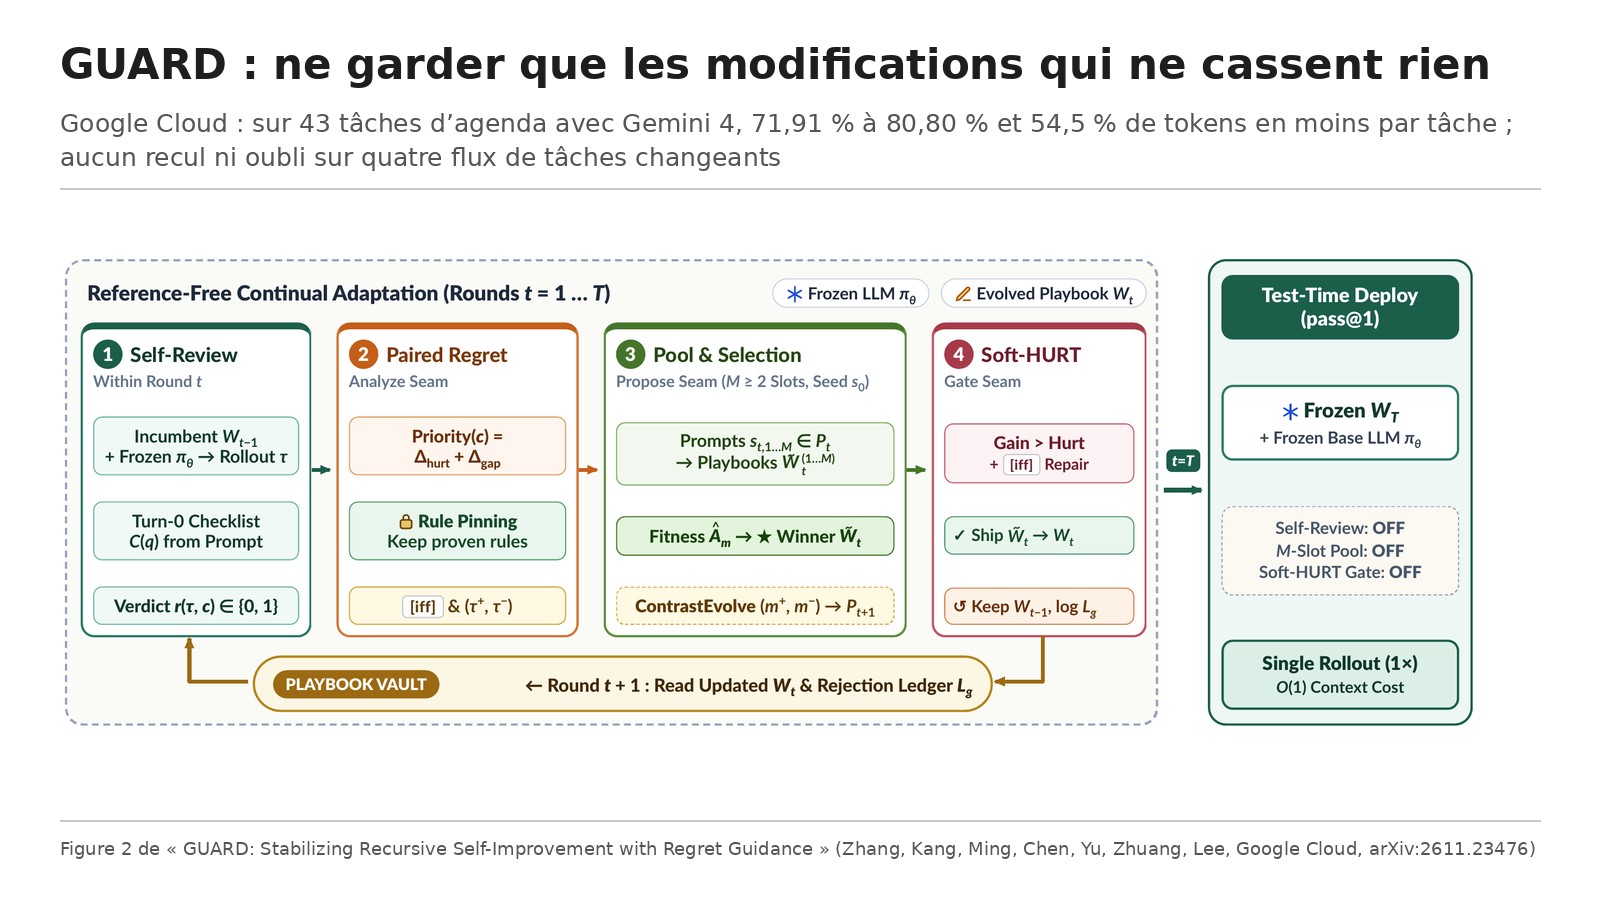
Avant d’exécuter une tâche, le modèle relecteur lit seulement la consigne, la déclaration des outils et le schéma, et en tire une liste fixe de contrôles binaires : exécution propre dans le bac à sable, identifiants valides, modifications non dupliquées, respect de chaque contrainte, destinataire, format et règle de sécurité. Après l’exécution, une première couche vérifie les contrôles techniques de façon déterministe sur une copie du bac à sable, une seconde juge les contrôles de sens un par un. Vérifier un critère sur une trace terminée est plus simple que tous les respecter en même temps pendant la génération. Aucune réponse de référence, aucun test caché ni barème officiel n’est utilisé pendant l’adaptation.
Trois listes : régressions, lacunes, acquis
À chaque tour, GUARD compare les deux derniers harnais sur les mêmes tâches. Un critère qui était respecté et ne l’est plus passe en tête des priorités ; un critère jamais respecté vient ensuite ; un critère toujours respecté est verrouillé pour que la prochaine réécriture n’y touche pas. Quand une règle provoque une régression, l’agent est invité à la restreindre par une condition explicite (une règle « [iff] … », valable seulement dans tel cas) plutôt qu’à la supprimer.
Plusieurs candidats, une porte de sécurité
L’agent rédige plusieurs harnais candidats en parallèle (deux dans la plupart des expériences), les fait tourner sur les mêmes tâches et garde le meilleur, en comparant le meilleur et le moins bon pour améliorer ses consignes de rédaction au tour suivant. Le gagnant ne remplace l’ancien harnais que s’il passe la porte Soft-HURT : ses gains doivent dépasser les régressions qu’il provoque. Les modifications refusées sont consignées pour ne pas être reproposées. En production, tout cela est désactivé : un seul harnais figé tourne, en un seul passage.
Les résultats sur les tâches d’entreprise
Sur la version hébergée d’EvoHarnessBench (outils d’agenda qui évoluent en trois étapes, 18 tâches d’entraînement, 43 tâches de test), avec Gemini 4 dans tous les rôles, GUARD atteint 80,80 % de précision, contre 71,91 % pour l’agent de départ, soit +8,89 points (8 tâches meilleures, aucune moins bonne, p = 0,008). Le meilleur concurrent, Meta-Harness, est à 74,52 % : l’écart de 6,28 points n’est pas statistiquement significatif (p = 0,11). GUARD résout entièrement 25 tâches sur 43 (58,14 %), contre 22 au mieux pour les autres. Son harnais est plus court (2 315 caractères contre 4 538 à 10 013), il n’épuise jamais le budget de huit étapes (contre 7 tâches sur 43 pour l’agent de départ) et consomme 59 651 tokens par tâche contre 131 032, soit 54,5 % de moins, avec 22,5 % d’appels d’outils en moins.
Sur un banc local plus large (236 tâches de test sur agenda, documents, gestion des tickets informatiques, service client et ressources humaines), le gain est plus mince : 65,81 % à 66,46 % en moyenne. Retirer le classement des régressions fait tomber cette moyenne à 59,13 %, retirer la porte Soft-HURT à 56,11 %.
Mémoire : des mises à jour justes sans pollution
Sur PAST-Bench (12 familles de tâches de mémoire entre sessions, avec Gemini 3.8 Flash comme exécutant et Claude Opus 5.5 comme relecteur), les méthodes qui accumulent sans trier (Hermes+, GEPA) gardent des règles périmées lors des mises à jour, et celles qui réécrivent agressivement (RRSI, Meta-Harness) mettent bien à jour (0,901 à 0,903) mais triplent la pollution de la mémoire (0,500 contre 0,167). GUARD obtient 90,1 % de mises à jour correctes sur les procédures en plusieurs étapes avec une pollution nulle sur celles-ci, et sur les 12 familles le meilleur score de mise à jour (0,924) au plancher de pollution de 0,167 qu’il partage avec Hermes+ et GEPA.
Pas d’oubli quand le travail change
Sur Drift Gauntlet, quatre flux de tâches (appels d’outils, requêtes SQL, environnement scientifique) qui changent sans avertissement, GUARD est la seule méthode dont la précision moyenne ne baisse jamais : 0 recul sur 12 changements de bloc, aucun oubli après un bloc, et 73,22 % en moyenne finale contre 69,92 % pour l’agent de départ. Les autres méthodes subissent 3 à 8 reculs sur 12. L’avance sur GEPA, deuxième, n’est que de 0,82 point, soit l’équivalent d’environ trois tâches.
Les limites
Le papier n’a pas de section consacrée aux limites. Plusieurs points ressortent de la lecture. Le chiffre de 80,80 % est celui de la dernière des cinq configurations testées sur le même jeu de test (de 75,57 % à 80,80 %, moyenne 77,09 %), même si toutes dépassent les concurrents. Sur ce banc, la porte n’a accepté une modification qu’à la première étape et s’est abstenue aux deux suivantes : tout le gain vient du premier harnais, et l’absence de régression ensuite tient en partie à cette abstention. Les jeux de test sont petits (43 tâches, dont 4 seulement pour la dernière étape), les évaluations principales reposent sur un seul tirage par tâche (et une seule graine sur Drift Gauntlet), et le gain sur le banc local de 236 tâches est inférieur à un point. Le relecteur est le même modèle que l’agent dans les expériences principales, ce qui suppose qu’il juge correctement ses propres traces ; les auteurs mesurent cet étalonnage mais il n’est pas parfait. Enfin, RRSI, l’une des méthodes comparées, vient en partie de la même équipe, et le code n’est pas publié.
Lecture Neurone21
Pour une entreprise qui laisse ses agents ajuster leurs propres consignes ou leur mémoire, GUARD formalise une règle de bon sens : une modification ne doit être conservée que si elle ne casse pas ce qui marchait déjà, mesuré sur les mêmes tâches. La liste de contrôles établie avant l’exécution est facile à reproduire sans le reste du système : demander au modèle de lister ce qu’une tâche exige, puis vérifier chaque point après coup, avec une vérification technique en dur avant le jugement du modèle. Le résultat sur les tokens est aussi instructif : un harnais plus court et mieux ciblé fait moins tourner l’agent en rond et coûte deux fois moins par tâche. Le papier rejoint la fiche Google publiée la veille sur les harnais modulaires validés étape par étape : dans les deux cas, ce qui protège l’agent n’est pas une meilleure réécriture mais une validation stricte avant déploiement. Les gains restent modestes hors du banc d’agenda, et il faudra le code pour juger sur pièces.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.23476v1. Points à préciser :
Les 43 tâches de test, les 80,80 % de précision, les +8,89 points sur le harnais de départ (p = 0,008) et les +6,28 points sur Meta-Harness sont dans le papier. Mais l’écart avec Meta-Harness n’est pas significatif (p = 0,11, intervalle de confiance de −0,4 à +14,5 points). La baisse de 54,5 % des tokens par tâche se mesure par rapport à l’agent de départ (59 651 contre 131 032), pas par rapport à Meta-Harness, qui consomme 78 705 tokens par tâche. Les 90,1 % de mises à jour correctes et la pollution nulle portent sur les procédures en plusieurs étapes de PAST-Bench ; sur les 12 familles, la pollution de GUARD est de 0,167, à égalité avec Hermes+ et GEPA, et nulle sur 10 familles. La pollution « triplée » des réécrivains agressifs (0,500 contre 0,167) est bien dans le papier. Les sept auteurs sont de Google Cloud. Yanfei Chen figure aussi parmi les auteurs du papier sur la mémoire des modifications que nous avons présenté le 17 novembre.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.23476
- Le PDF : https://arxiv.org/pdf/2611.23476
- Notre fiche sur les harnais auto-améliorants modulaires chez Google : /p/harnais-auto-ameliorants-cadre-modulaire-google
- Notre fiche sur la mémoire des modifications pour l’auto-amélioration continue chez Google : /p/memoire-auto-amelioration-harnais-rsi-continu-google
- Notre fiche sur les agents auto-évolutifs qui apprennent en oubliant (le banc Drift Gauntlet) : /p/agents-auto-evolutifs-oubli
- Notre explication de base sur le harnais d’agent : /p/harnais-ia-agent-a-quoi-ca-sert