Titre original : RAG in a Trenchcoat: When Minimal Memory Is Enough for Agentic Systems, and When It Isn’t
Auteurs : Jingyu Liu (auteur correspondant), Zongze Li, Zach Xu, Zhanhui Zhou, Tahseen Rabbani, Dawn Song et Ce Zhang.
Affiliations : University of Chicago et University of California, Berkeley (Zhanhui Zhou, Dawn Song). Travail financé par le laboratoire de Ce Zhang à Chicago, selon les auteurs.
Publication : prépublication déposée sur arXiv le 17 novembre 2026 (2611.22179v1, 38 pages avec annexes), mise en page pour NeurIPS 2026. Code publié sur GitHub.
Liens : page arXiv, PDF, code sur GitHub.
L’idée en bref
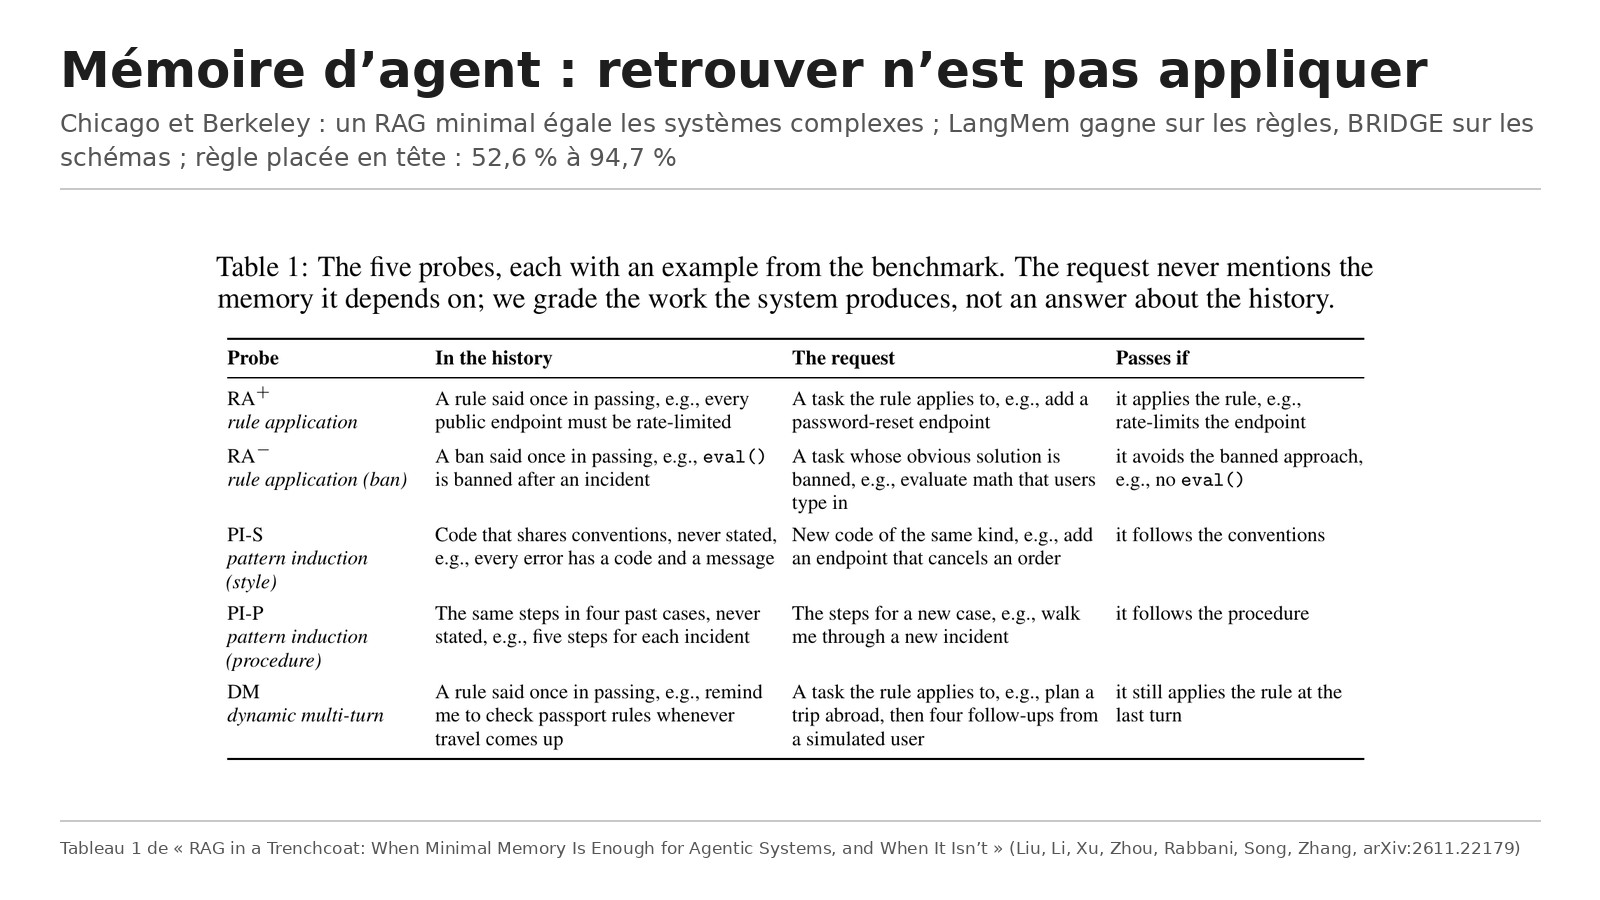
En deux ans, la mémoire des agents s’est beaucoup compliquée : extraction de faits, gestion des informations périmées, passes de réflexion, graphes de connaissances. Le titre le dit avec humour : BRIDGE est un « RAG déguisé », une recherche documentaire simple (retrieval-augmented generation) avec un mince habillage. Les auteurs montrent qu’il égale les systèmes complexes sur les benchmarks standards. Leur conclusion n’est pas que BRIDGE est meilleur, mais que ces benchmarks, qui posent des questions sur le passé, ne savent pas départager les architectures. Ils proposent donc cinq tests où l’agent doit agir selon sa mémoire, sans qu’on la lui rappelle.
Ce que montre le papier
BRIDGE, une mémoire minimale
À chaque bloc de conversation (une session, ou 2 000 tokens au plus), un appel au modèle rédige une note d’observation, en voyant les 10 notes précédentes pour garder le fil. BRIDGE garde la note et le texte brut. Pour une question, il cherche à la fois par mots-clés (BM25, sur la note et le texte) et par similarité vectorielle, fusionne les deux classements, retient 10 blocs, en affiche 3 en texte brut et 7 sous forme de note, puis les remet dans l’ordre chronologique. Un seul appel au modèle par écriture et par question, et 5 000 à 7 000 tokens de contexte par question, soit 17 à 154 fois moins que de donner tout l’historique.
À égalité avec les meilleurs sur les benchmarks standards
À modèle lecteur identique, BRIDGE obtient 0,370 sur BEAM 100K (moyenne des 10 capacités, GPT-4.1-nano), contre 0,345 pour LIGHT. Sur LongMemEval-S (GPT-4o), il reste 1,4 point derrière EmergenceMem, avec des intervalles de confiance qui se recouvrent. Sur EverMemBench, il dépasse MemOS, le meilleur système de mémoire du benchmark, de 5,7 points (GPT-4.1-mini) et 6,3 points (Gemini-3-Flash), et reste 7,1 points sous le contexte complet, contre 13 à 20 points pour les systèmes publiés. Remettre les blocs dans l’ordre compte : sans ce tri, BRIDGE perd 7,7 points sur les questions de mise à jour de LongMemEval-S.
Cinq tests où l’agent doit agir selon sa mémoire
Chaque scénario est un historique daté de sessions, suivi d’une demande ordinaire qui ne cite jamais ce qu’il faut se rappeler. Exemple réel : dans la troisième de dix sessions, au milieu d’un retour sur incident, l’utilisateur glisse que « tout endpoint public doit avoir un limiteur de débit ». Après les sept sessions suivantes, consacrées à d’autres sujets, il demande un endpoint de réinitialisation de mot de passe. La réponse ne passe que si l’endpoint est limité. Les cinq tests couvrent l’application d’une règle, le respect d’une interdiction (par exemple ne pas utiliser eval()), la reproduction de conventions de code jamais énoncées, le suivi d’une procédure montrée quatre fois, et le maintien d’une règle sur un dialogue de cinq tours. Chacun compte 20 scénarios, générés par un modèle et notés par un juge d’un autre fournisseur.
Aucune architecture ne gagne partout
LangMem, qui extrait des faits atomiques, gagne sur les règles : 80 % contre 35 % pour BRIDGE sur l’application d’une règle, 90 % contre 55 % sur l’interdiction, 75 % contre 40 % sur le dialogue. BRIDGE gagne sur les schémas : 81 % contre 47 % sur les conventions de code, 88 % contre 55 % sur la procédure. Mem0 et Graphiti ne gagnent aucun test. La raison est structurelle : un extracteur de faits n’a rien à extraire d’un schéma jamais énoncé, alors qu’une note par bloc garde la forme du travail mais noie la règle parmi d’autres remarques. Les écarts gardent leur sens sur 87 scénarios ajoutés dans trois autres domaines (opérations cliniques, conformité juridique, finance), avec deux autres juges et trois autres modèles lecteurs. Quand les tests se durcissent (plus de sessions de remplissage, sujets voisins qui font concurrence), l’avance de LangMem sur les règles disparaît (43,8 % contre 42,9 %) et celle de BRIDGE sur la procédure se réduit (72,6 % contre 52,9 %).
Retrouver n’est pas appliquer
Envoyer chaque demande vers la meilleure architecture rapporterait 13,6 points, mais la demande ne dit rien de ce dont elle a besoin : un classifieur ne fait pas mieux que le hasard. Les auteurs regardent donc où BRIDGE échoue sur les règles. Le bloc contenant la règle est retrouvé dans les 20 scénarios, et dans 12 des 13 échecs la règle arrive même en texte brut au modèle : il la voit et ne l’applique pas. Un appel supplémentaire qui extrait les consignes permanentes des blocs retrouvés et les place en tête du contexte fait passer BRIDGE de 52,6 % à 94,7 % sur ce test, devant LangMem (80 %) et au niveau du modèle qui lit tout l’historique (90 %). Un résumé générique de même coût fait moins bien que rien (40,0 %).
Les limites
Les auteurs les listent. Avec 20 scénarios par test, un scénario déplace un score de 5 points, et ils n’interprètent pas d’écart inférieur à 15 points environ. Les scénarios sont écrits par un modèle, la vérification humaine s’est limitée à un échantillon relu par les auteurs, le test de dialogue n’a été lancé qu’une fois, et le modèle de référence comme le générateur viennent de la même famille. Le juge vérifie qu’une contrainte mémorisée est respectée, pas que la réponse est bonne par ailleurs. Enfin, ce sont des tests fixes, pas des agents vivants avec outils, longues durées et utilisateurs changeants.
Nos réserves : les chiffres de référence des systèmes concurrents sur les benchmarks standards viennent de leurs propres publications, avec leurs réglages ; les auteurs parlent donc de parité, pas de supériorité. Sur BEAM, l’avantage de BRIDGE tient à une seule capacité, l’ordre des événements : sans elle, il passe juste derrière LIGHT (0,360 contre 0,375). Et le gain spectaculaire de la règle placée en tête porte sur un seul test, dont les scores varient d’un run à l’autre (35 % puis 52,6 % pour BRIDGE inchangé).
Lecture Neurone21
Pour une entreprise qui déploie un assistant de code ou de support avec mémoire, deux leçons. D’abord, avant d’adopter un système de mémoire complexe, il faut le comparer à une base simple et peu coûteuse comme BRIDGE : sur les questions de rappel, elle fait aussi bien pour quelques milliers de tokens. Ensuite, la vraie difficulté n’est pas de retrouver une consigne mais de la faire appliquer : une règle de sécurité dite une fois en réunion sera retrouvée, mais pas forcément respectée. Mettre les consignes permanentes à part, en tête du contexte, est une mesure simple et efficace. Les auteurs rappellent aussi l’envers du décor : une mémoire qui applique des règles sans qu’on les redise appliquera aussi les règles périmées ou fausses, d’où l’intérêt de laisser les utilisateurs voir et effacer ce qui est retenu.
D’où vient ce papier
Nous avons lu la version officielle arXiv 2611.22179v1. Points à préciser :
La parité sur LongMemEval-S et BEAM, l’avance de 5,7 à 6,3 points sur EverMemBench, un appel au modèle par écriture ou par question et 5 000 à 7 000 tokens par question sont conformes au papier. Trois nuances. Sur BEAM, la parité dépend de la capacité « ordre des événements », notée avec une métrique que les auteurs jugent peu fiable. LangMem gagne non seulement l’application des règles mais aussi le test de dialogue sur plusieurs tours. Et « montrer la règle plus en évidence » comble l’essentiel de l’écart sur le test d’origine, mais au niveau le plus dur un résumé générique récupère déjà une bonne partie du gain : les auteurs présentent ce résultat comme un diagnostic, pas comme une méthode.
Ce papier ne doit pas être confondu avec celui que nous avons présenté le 23 octobre (arXiv 2610.30755), qui opposait déjà un RAG sur l’historique brut aux systèmes de mémoire, mais sans tests d’application.
Pour aller plus loin
- Le papier sur arXiv : https://arxiv.org/abs/2611.22179
- Le PDF : https://arxiv.org/pdf/2611.22179
- Le code et les tests : https://github.com/Jingyu6/rag-in-a-trenchcoat
- Notre fiche sur un RAG simple sur l’historique brut face aux mémoires complexes : /p/rag-brut-bat-memoire-agentique-conversations
- Notre fiche sur la Memory Tax, le coût de la mémoire des agents face à un RAG naïf : /p/taxe-memoire-agents-rag-naif
- Notre fiche sur RIME, une autre approche de la mémoire pour l’apprentissage continu : /p/rime-memoire-agents-apprentissage-continu-cmu